Local LLM
Développer localement avec l'IA
Pourquoi est-il si difficile de faire tourner un LLM en local ? Entre VRAM, contexte et quantification, voici comment je développe avec l'IA sur une carte graphique de 16 Go.
Introduction
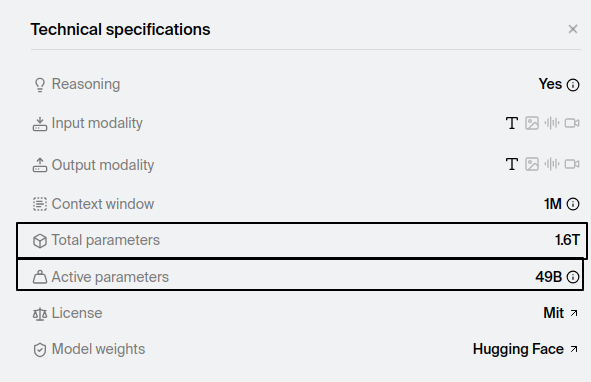
Récemment, Apple a annoncé le MacBook Pro M5 Pro et le M5 Max. Deux monstres informatiques capables de faire tourner des IA localement, avec entre 24 Go et 128 Go de mémoire unifiée. Pourtant, même avec une telle machine, vous ne pourriez pas faire tourner le modèle DeepSeek, qui nécessite aujourd’hui 1,4 To de VRAM.
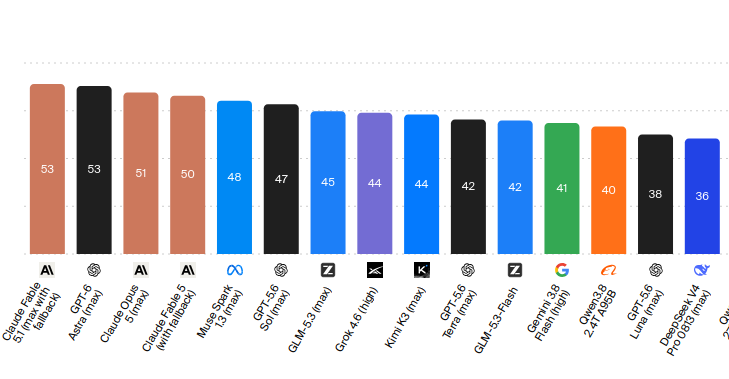
Le pire étant que ce modèle est excellent, mais qu’il n’arrive qu’en 15e position de l’index d’intelligence des LLM. (ref)
Une question s’impose :
Pourquoi est-ce si compliqué de servir une intelligence artificielle ?
De quoi un LLM a-t-il besoin pour fonctionner ?
D’un point de vue matériel, un LLM a besoin de deux éléments principaux :
- une carte graphique (avec beaucoup de VRAM)
- de la RAM
C’est quoi la VRAM ?
La VRAM (Video Random Access Memory), vulgarisée, c’est la quantité de données que votre carte graphique peut stocker et traiter. C’est exactement la même chose que la RAM, mais dédiée exclusivement à la carte graphique.
Comment fonctionne l’inférence d’un LLM
Contexte
La compréhension du mécanisme complet d’inférence d’un LLM est très complexe. Ce qu’il faut comprendre, c’est que le document académique Attention Is All You Need a expliqué en 2017 comment l’architecture Transformer permettait de réaliser des opérations en parallèle plutôt qu’en séquentiel sur des cartes graphiques. C’est ce qui a donné naissance à la famille des modèles GPT, dont le célèbre GPT-3.
Fonctionnement concret
Cette section explique comment un modèle d’IA fonctionne localement sur un ordinateur.
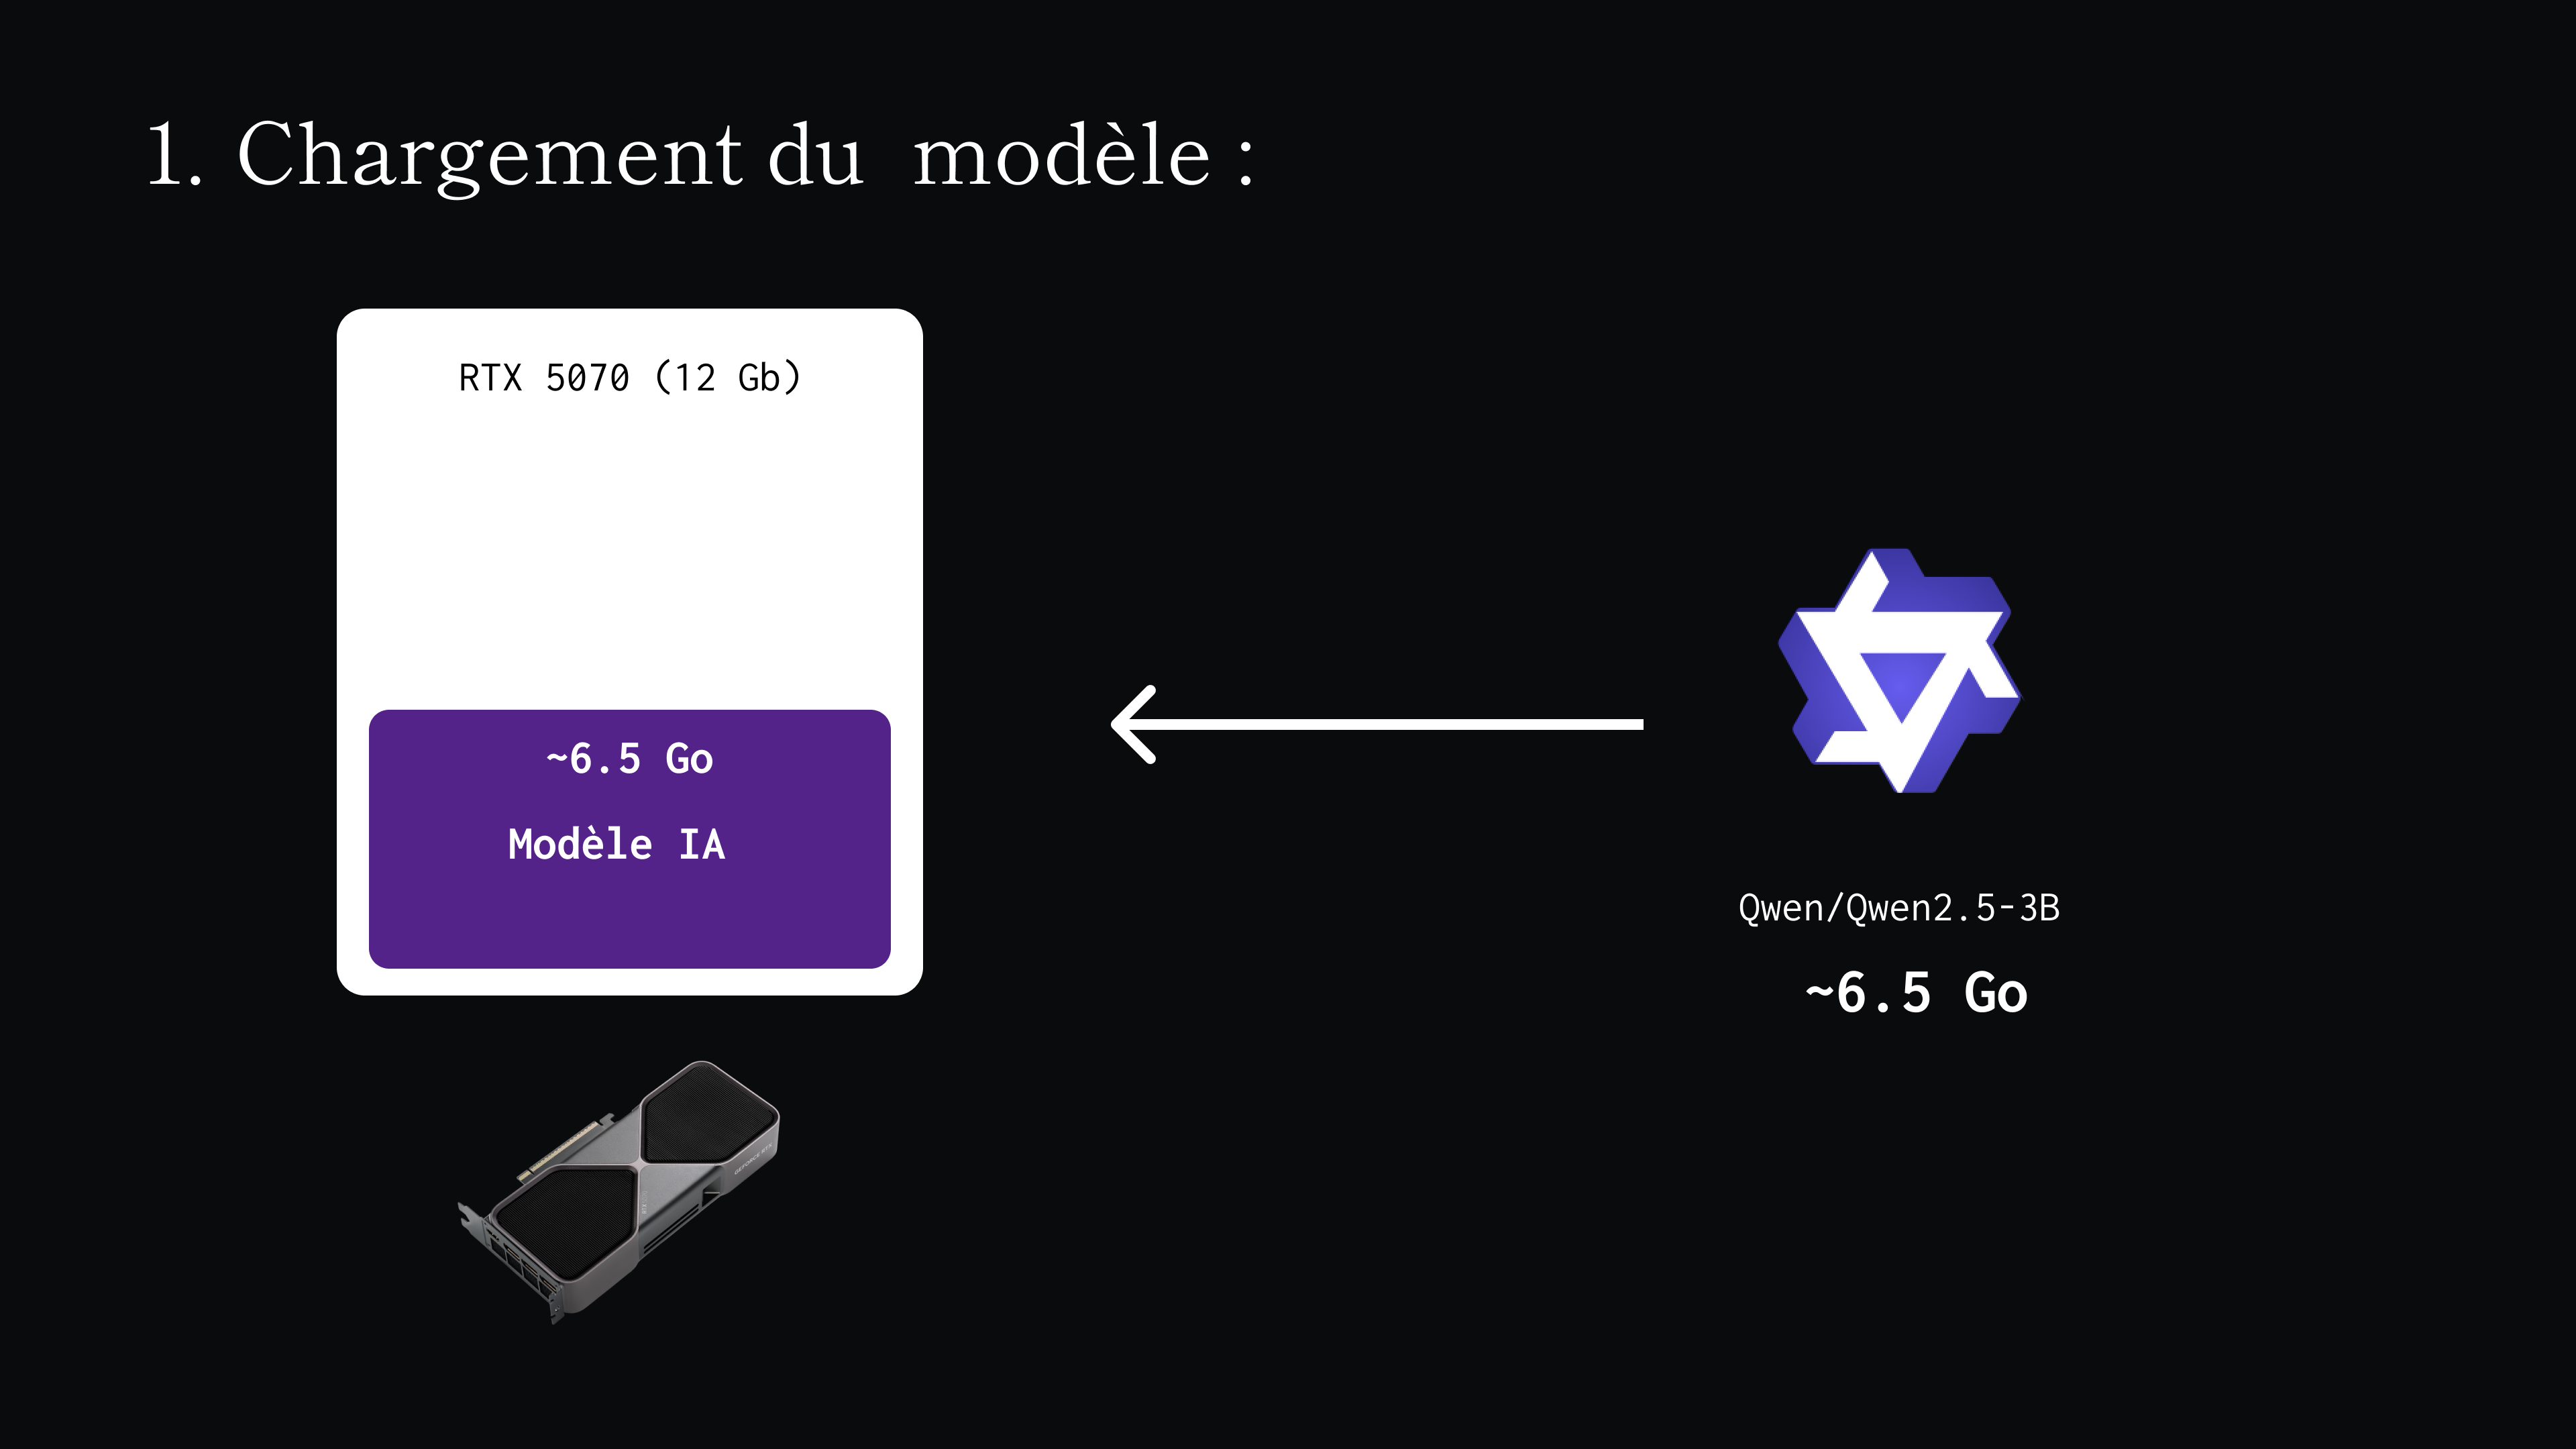
1. Chargement du modèle
Le modèle est un fichier généralement en extension .safetensors, .gguf ou .pth qui représente les poids du modèle (le modèle en lui-même).
Celui-ci doit être importé entièrement dans la mémoire de votre carte graphique (votre VRAM) ! Toute la difficulté de l’inférence d’une IA réside ici : l’intégralité du modèle doit tenir dans votre carte graphique.
2. Inférence
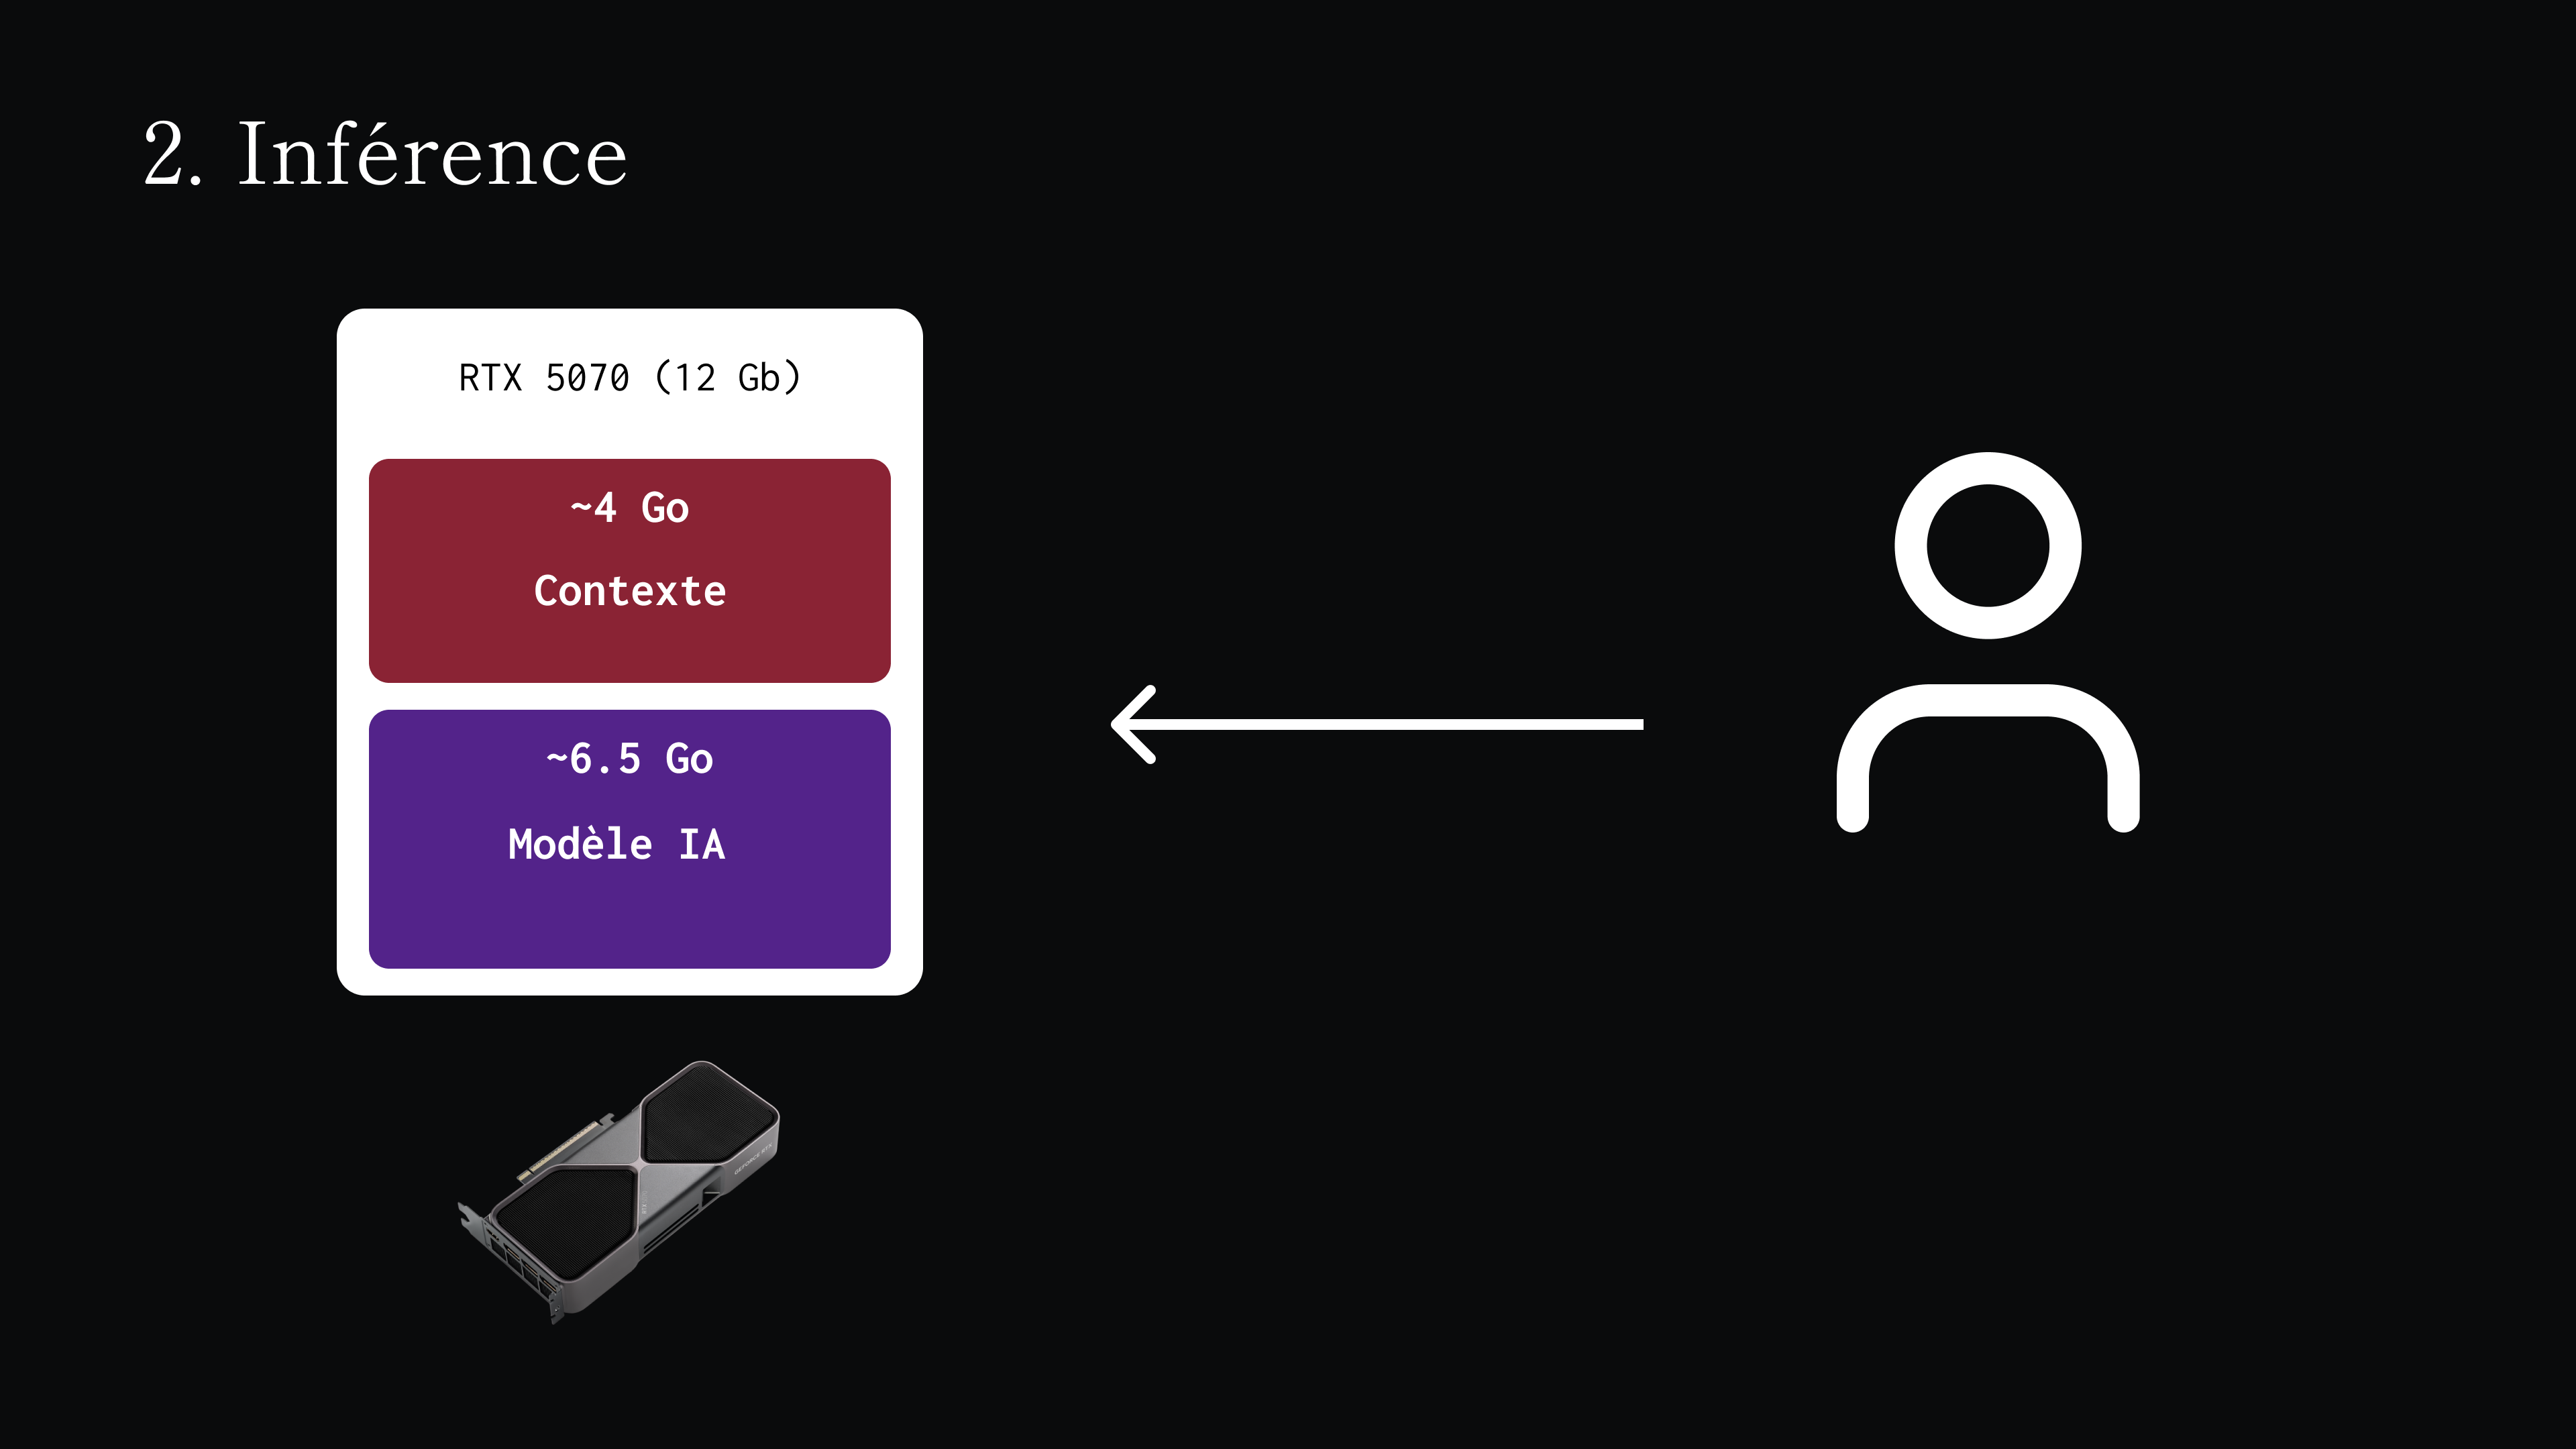
Votre LLM est maintenant dans la mémoire de votre carte graphique et vous pouvez discuter avec lui. Au fur et à mesure que vous discutez avec votre LLM, un autre paramètre va entrer dans l’équation : le contexte.
C’est quoi le contexte ?
Le contexte, c’est la quantité d’informations qu’une IA peut stocker au cours d’une discussion. Pour que le LLM se rappelle des messages précédents (aussi bien ceux des utilisateurs que les siens), il est nécessaire de les stocker quelque part.
Où se situe le contexte ?
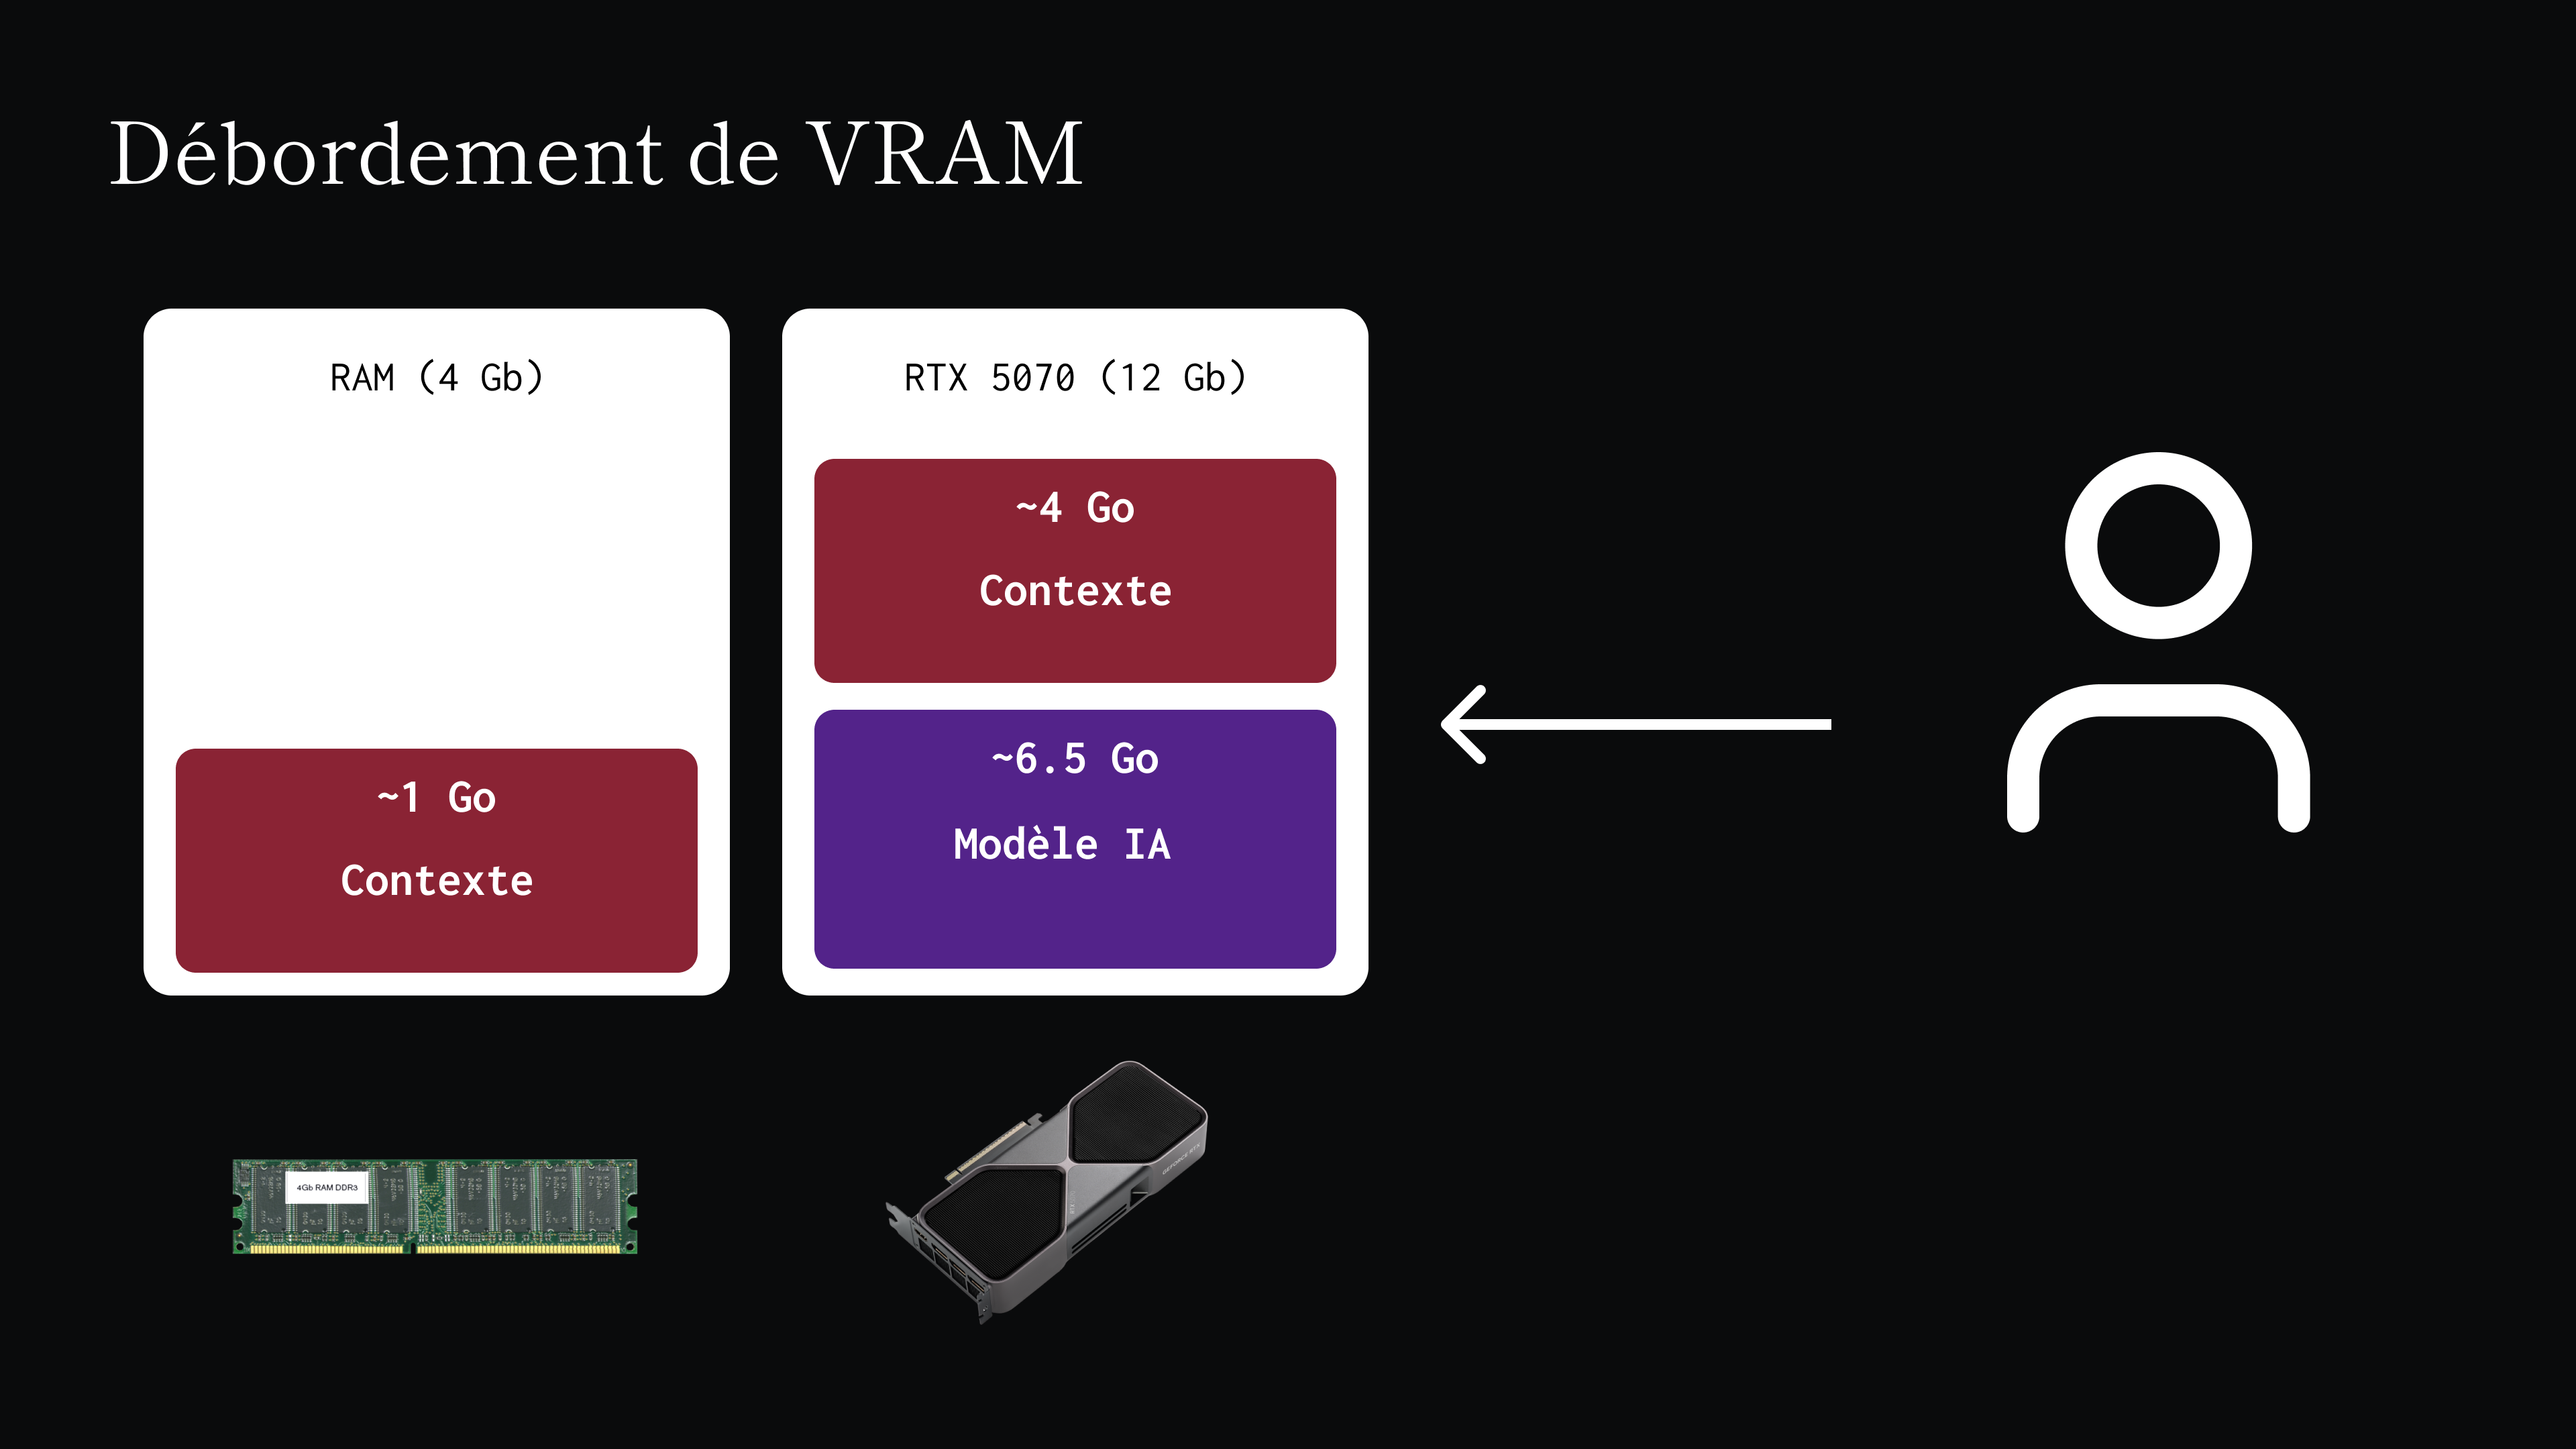
Le contexte doit aussi se situer dans la VRAM. C’est un paramètre qui complique d’autant plus l’opération : nous sommes déjà limités par la taille du modèle, à laquelle s’ajoute désormais le contexte.
Plus le modèle est grand, plus le stockage du contexte en VRAM coûte cher.
| Modèle | Paramètres | Consommation moyenne par token |
|---|---|---|
| Mistral 7B | 7 milliards | ~0,13 Mo par token |
| Llama 3 70B | 70 milliards | ~0,65 Mo par token (quintuplé) |
Il est aussi important de comprendre qu’une conversation ne peut pas être infinie. Chaque modèle possède une limite de contexte appelée Context Window.
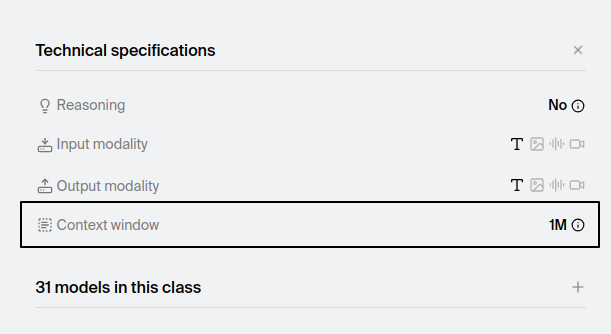
Le principe est simple. Lorsque l’on commence une conversation, le contexte est à 0 (ou quelques milliers de tokens avec des instructions). Par la suite, plus l’utilisateur parle avec l’IA, plus le contexte se remplit.
Et si le contexte et le modèle dépassent la VRAM ?
Plus haut, je mentionnais que la RAM est un composant important pour l’inférence d’une intelligence artificielle. Lorsque la carte graphique ne peut plus supporter la charge du modèle et du contexte, les données excédentaires sont déversées dans la RAM classique. Malheureusement, cela a une conséquence considérable sur les performances : la RAM est beaucoup plus lente que la VRAM, et les performances de génération chutent. On passe de 20 à 30 tokens par seconde à quelques tokens par seconde.
Le compromis
Comme vous avez pu le comprendre, il est nécessaire de trouver un compromis. Les deux situations extrêmes sont les suivantes :
L’intelligence sans mémoire
Vous avez un agent extrêmement intelligent, mais votre contexte est limité à une dizaine de milliers de tokens.
Résultat : une intelligence inexploitable, car la moindre tâche complexe qui nécessite de la réflexion ou de la recherche épuisera le contexte existant.
Le simplet bavard
Vous avez un agent très peu intelligent, mais il dispose d’un contexte gigantesque de plus de cent mille tokens.
Résultat : un agent qui peut réfléchir longtemps, mais qui techniquement n’est pas assez intelligent pour réaliser une tâche complexe.
Le meilleur compromis
Tout dépend des tâches réalisées par le LLM. Il faut trouver le sweet spot entre un contexte exploitable et une intelligence suffisante.
Pour un travail de traduction de quelques pages, le contexte n’a pas besoin d’être immense. Pour un travail de codage agentique, le contexte devra être important.
C’est un paramètre propre à chaque installation et à chaque usage.
Des optimisations existantes
Il existe aujourd’hui énormément de manières de réduire la taille du contexte et celle du modèle tout en conservant leur qualité.
La quantification du modèle
Le principe de la quantification est de prendre un LLM et de réduire la précision numérique des poids et des activations d’un modèle dans le but de réduire sa taille, et donc son empreinte mémoire.
| Modèle | Quantification | Poids |
|---|---|---|
| Qwen3.8-27B | F16 (flottant 16 bits) | ~55,6 Go |
| Qwen3.8-27B-4bit | F4 (flottant 4 bits) | ~16 Go |
La quantification du KV cache
Il s’agit du même principe, mais appliqué au contexte.
MoE (Mixture of Experts)
Le concept est récent et très complexe. Le principe est que le modèle est segmenté en “unités d’expertise” et que, durant l’inférence, au lieu de charger l’intégralité du modèle, seules une partie de ces unités d’experts sont appelées.
Ma configuration avec 16 Go de VRAM
C’est un sujet que je trouve passionnant et que j’essaie d’intégrer dans mon travail. Cette section va décrire le meilleur compromis que j’ai actuellement avec mon matériel. Je considère mon matériel comme étant déjà moyen/haut de gamme.
Mon matériel
| Matériel | Modèle |
|---|---|
| Carte graphique | RTX 5070 Ti (16 Go de VRAM) |
| RAM | 32 Go |
Ma configuration
Moteur d’inférence
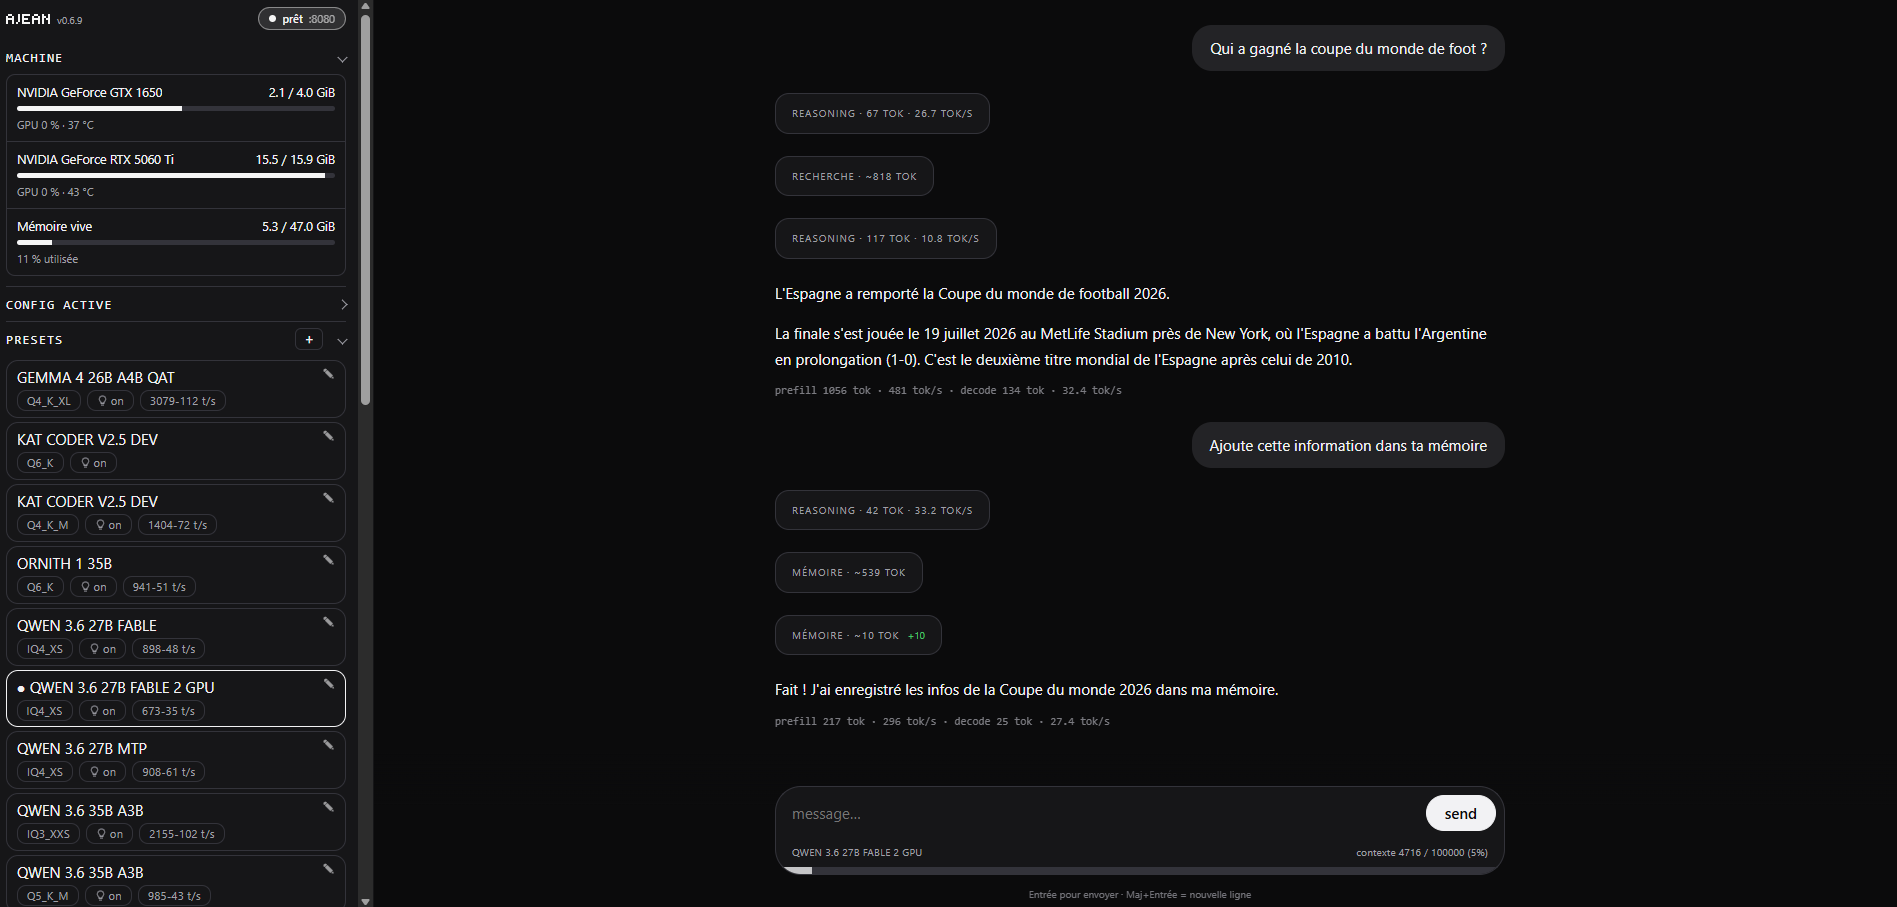
Pour réaliser l’inférence sur ma machine, j’utilise l’outil AJEAN, car il s’appuie sur llama.cpp comme moteur d’inférence et permet un contrôle beaucoup plus fin que des alternatives comme Ollama.
Modèle
Pour réaliser des tâches de code et de développement, j’utilise majoritairement le modèle Qwen3.8-27B-UD-IQ4_XS. Il fait 15,4 Go, ce qui peut paraître très juste pour le contexte, mais la quantification du KV cache permet en réalité de conserver une bonne marge de manœuvre. De plus, le modèle IQ4, bien que quantifié, parvient à conserver une intelligence relativement correcte sur des tâches complexes. Le MTP (Multi-Token Prediction, ou prédiction multi-token) est désactivé, sinon le contexte en est trop impacté et les bénéfices ne sont pas significatifs. Enfin, avec 16 Go de VRAM, la vision n’est pas envisageable sans conséquence sur l’intelligence du modèle.
Harness
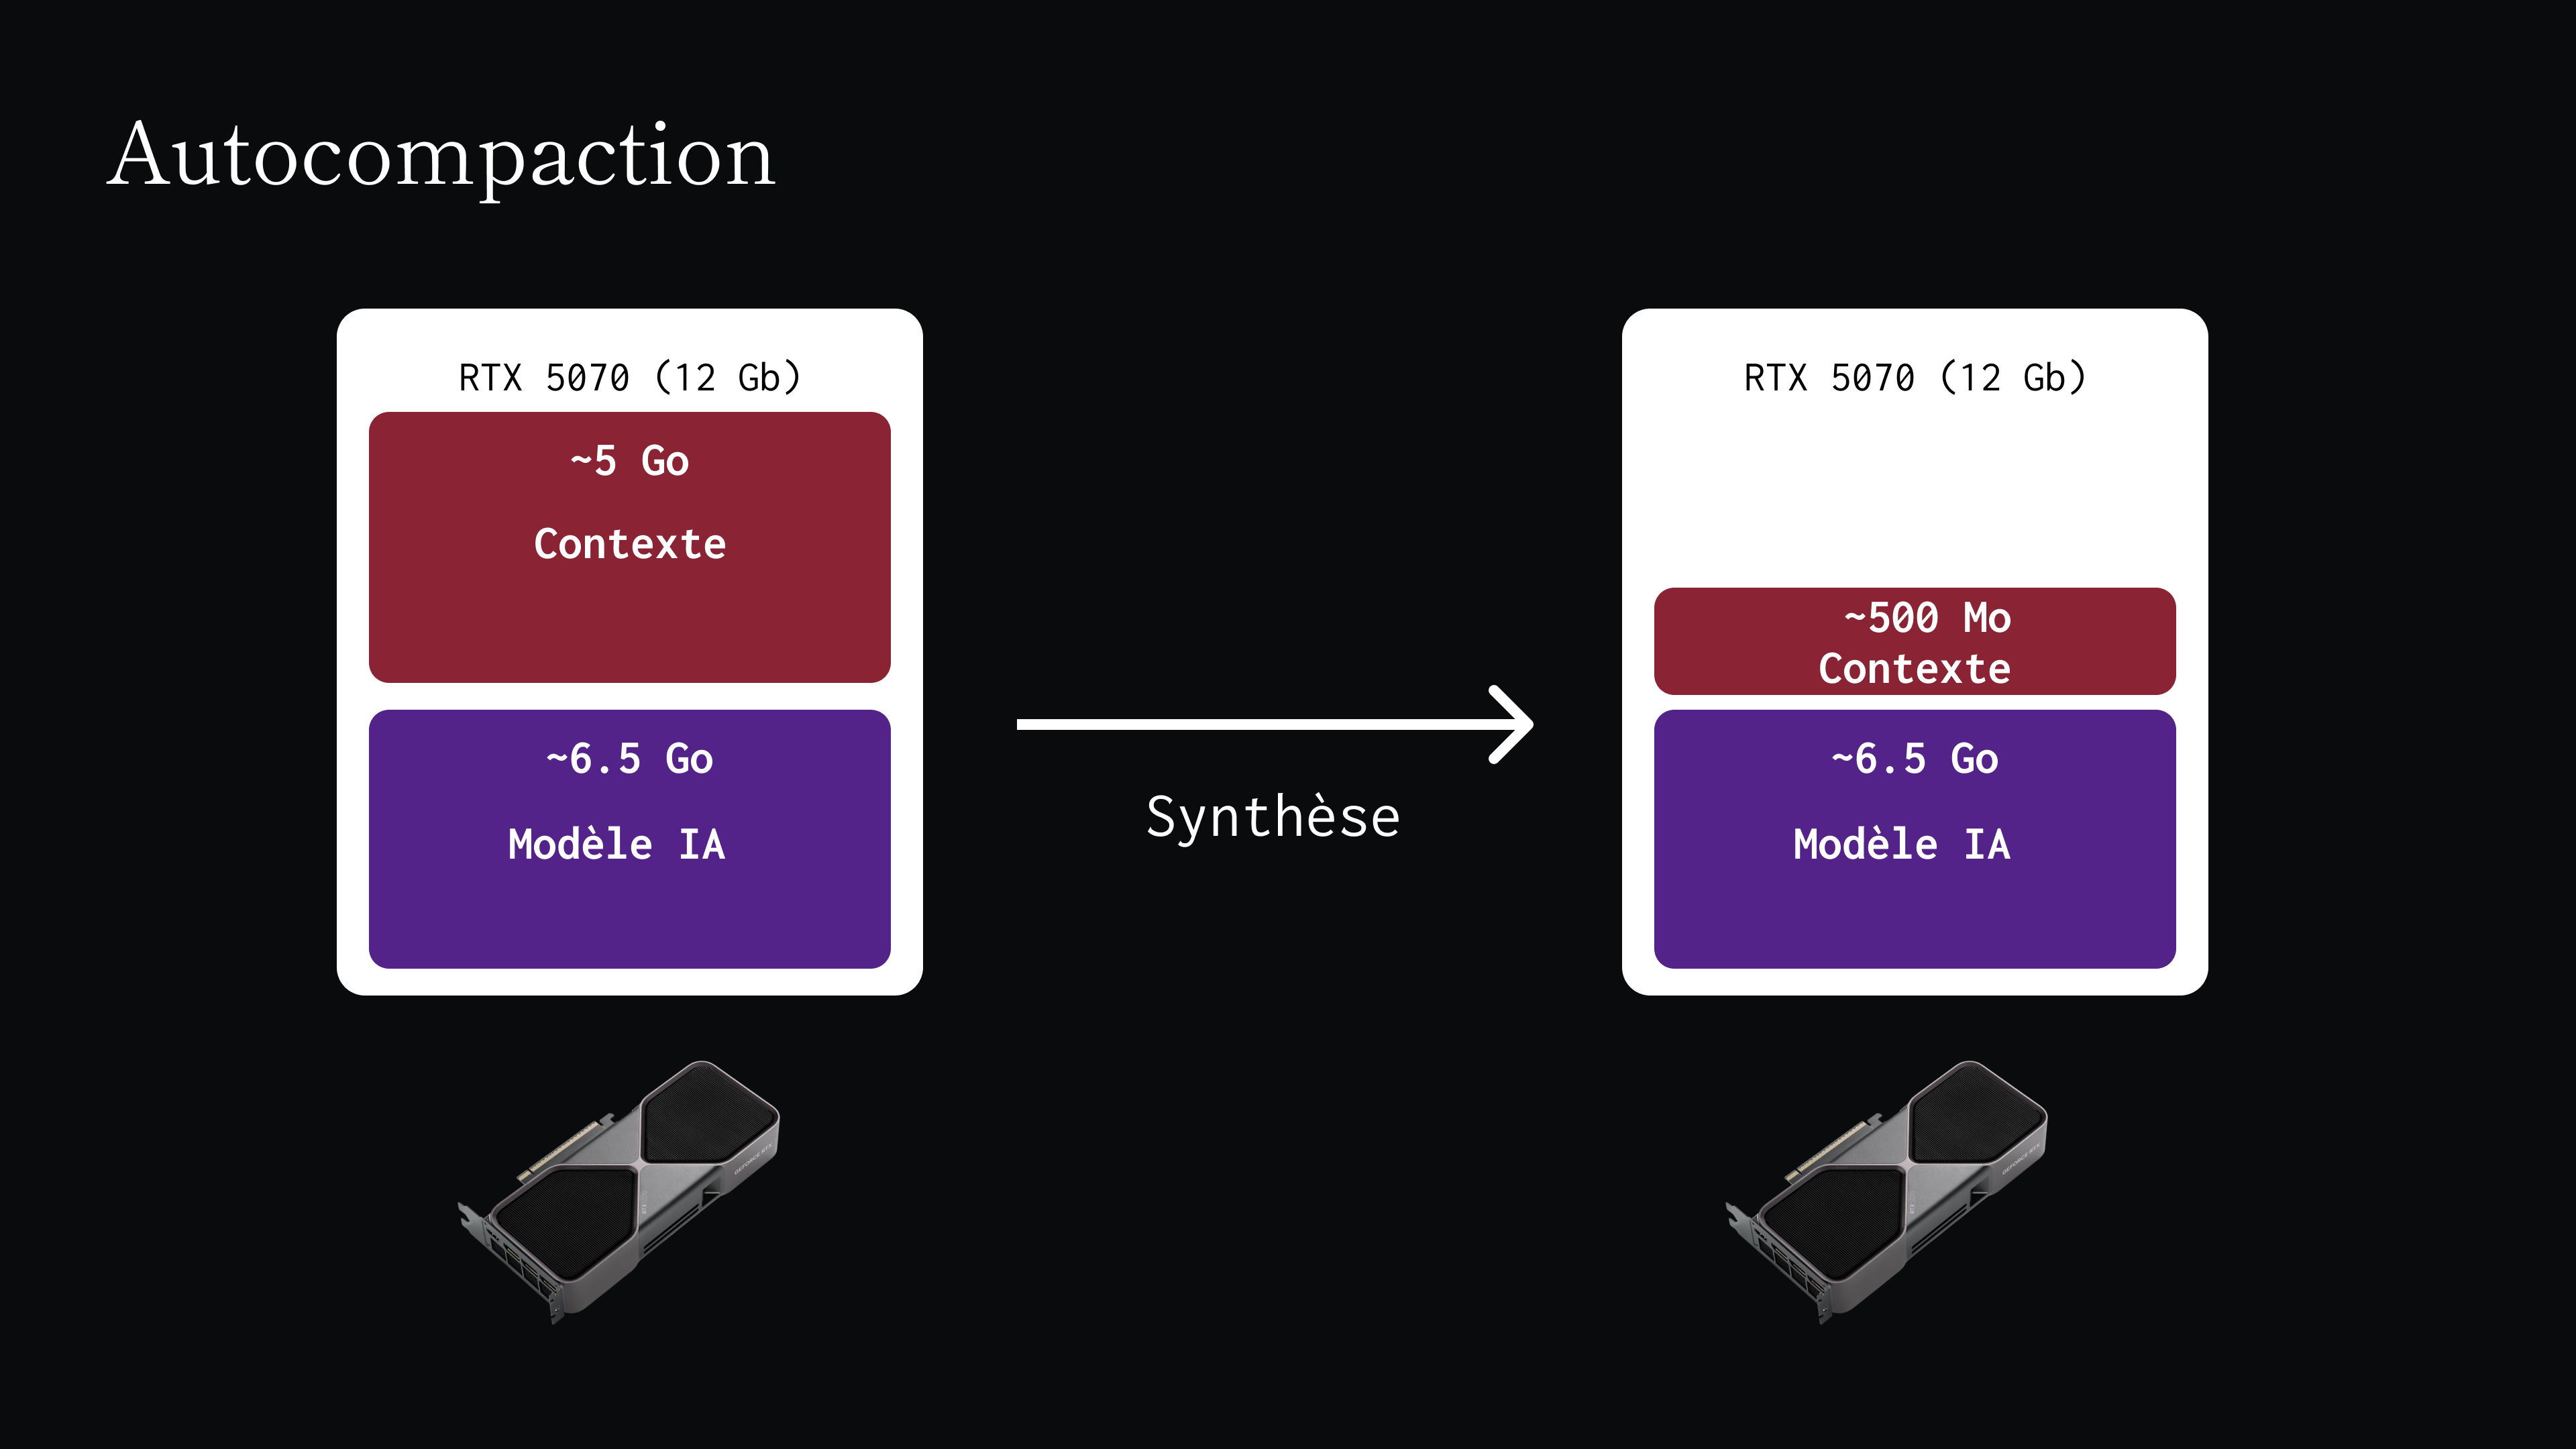
Comme indiqué dans cette note, OpenCode n’est pas pratique pour du développement local, notamment à cause du contexte initial injecté dans chaque conversation. Par conséquent, j’utilise Pi, qui permet une meilleure gestion du contexte. Ces deux plateformes de harness disposent d’une fonctionnalité d’auto-compaction. Lorsque l’espace VRAM disponible arrive à saturation, le harness reprend l’intégralité du contexte et réalise un travail de synthèse. Le contexte est ensuite vidé, et le résumé est injecté à sa place.